 LatenTX
 Realtime API 接入指南
版本:2026-11-17.2。支持 OpenAI Realtime GA 的 WebSocket 事件子集,非全量实现。
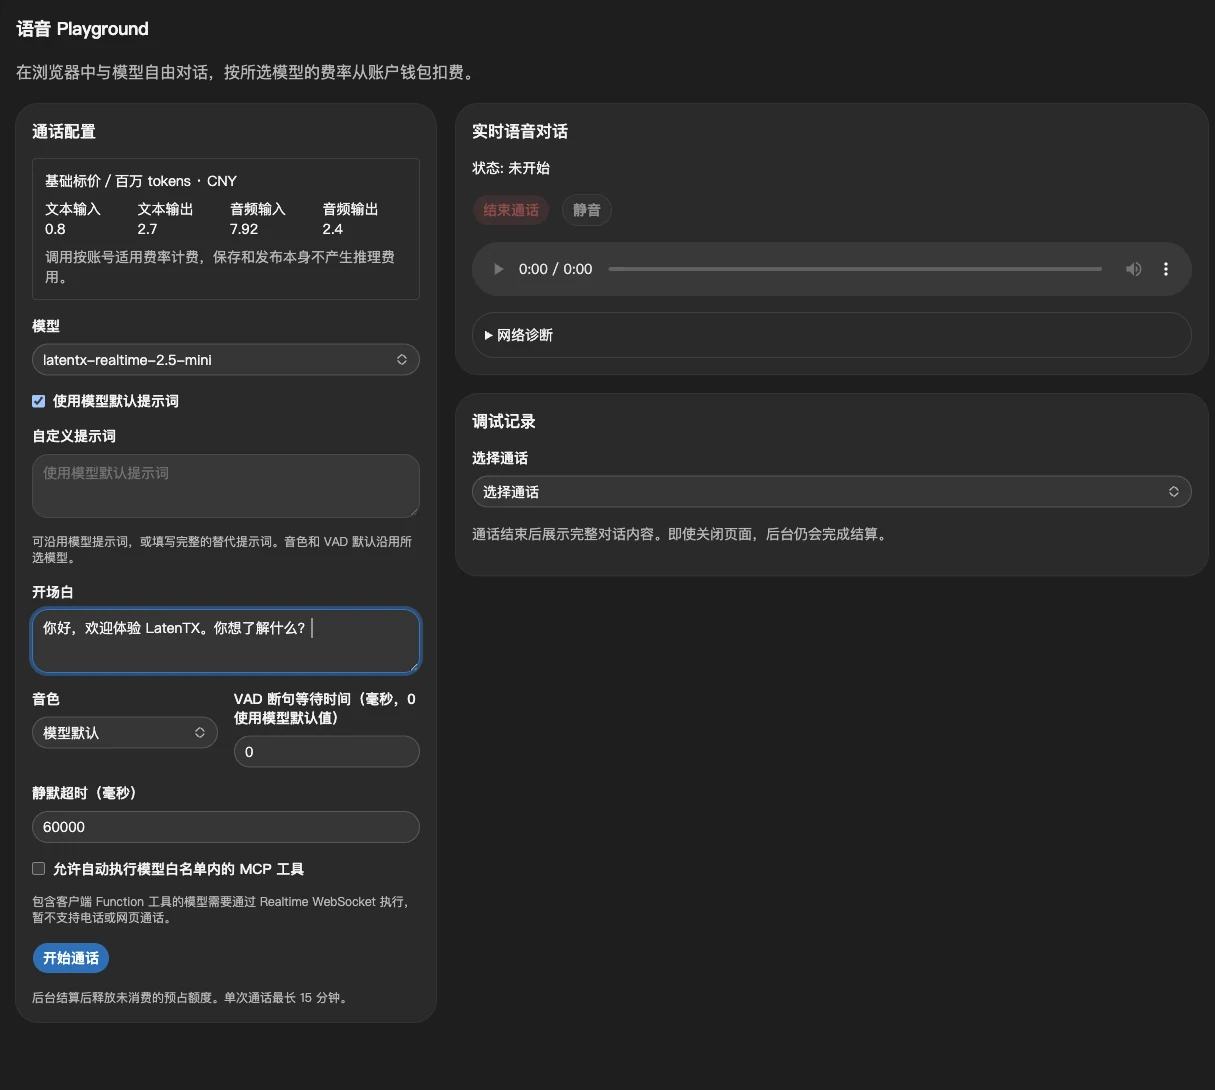
想先熟悉语音效果?在 Playground 选择型号、音色和开场白,再开始对话。下面的 API 指南将同样的模型接入你的后端;Playground 使用网页语音链路,不是 WebSocket 协议调试器。
两条接入路径
| 预定义 LatenTX 模型 | 已发布自定义模型 |
|---|---|
| 选择 Max / Plus / Mini 或多语言型号,连接后通过 session.update 临时配置 instructions、tools 和音频参数。配置只作用于当前连接,无需注册 Agent。 | 沿用 Console / Admin API 的草稿 → 校验 → 发布流程,直接使用返回的 custom-…-vN 模型 ID。组件、流程 Skill、知识和工具配置由发布版本带入;不需要额外 Agent ID。 |
当前会话配置不会保存为自定义模型,也不会影响其他连接。自定义模型已发布版本、Playground 和电话绑定方式保持原有协议。
最短接入路径
注册 Console → 创建有额度的 API Key → 选择型号 → 发送配置及文本/音频。无需创建 Agent、发布绑定或注册 Skill/MCP。
-
地址:
wss://api.latenth.com/v1/realtime?model=latentx-realtime-2.5-mini - Header:
Authorization: Bearer <API_KEY> -
型号:
latentx-realtime-2.5-max、latentx-realtime-2.5-plus、latentx-realtime-2.5-mini,多语言型号latentx-realtime-2.5-multilingual-max、latentx-realtime-2.5-multilingual-mini。语言和音色从GET /voice/v1/catalog的对应型号读取。 -
同一 Key 可访问
/v1/models、Realtime、租户内/voice/v1/*;按账户、Key 额度及型号授权执行。 -
长期 Key 放客户后端。浏览器的现有 Web
SDK/短期凭证走独立的网页语音/WebRTC 入口,不等同于 OpenAI 原生
WebRTC/
client_secrets。
连接收到 session.created 后发送:
{"type":"session.update","session":{"type":"realtime","output_modalities":["text"],"instructions":"你是客服助手,请简短回答。"}}
等待 session.updated,然后:
{"type":"conversation.item.create","item":{"type":"message","role":"user","content":[{"type":"input_text","text":"你好"}]}}
{"type":"response.create"}
读取 response.output_text.delta;response.done
表示本次模型响应结束。一次 WebSocket 可多轮交互。必须检查
response.done.response.status == "completed",错误、取消或提前断开不能视为成功。
文本、音频与打断
output_modalities 只能选
["text"] 或
["audio"]。音频模式同时产生
response.output_audio.delta(Base64 PCM)和
response.output_audio_transcript.delta。
音频格式:PCM16 little-endian、单声道、24kHz。将采集音频分块发为
input_audio_buffer.append 的 audio。默认
server_vad,静音阈值
300ms。收到声音不等于已形成有效转写;输入被接纳且开启自动回复时才会创建响应。
手动模式先配置:
{"type":"session.update","session":{"audio":{"input":{"turn_detection":null}},"output_modalities":["audio"]}}
发送音频后依次
input_audio_buffer.commit、response.create。可以先等
conversation.item.input_audio_transcription.completed
查看识别结果。空音频或无有效转写不会伪造用户消息。
response.cancel 停止正在生成的响应;conversation.item.truncate
传 assistant
item_id、content_index=0、audio_end_ms,以实际已播放位置修正历史。已产生的用量仍计费。
下载的 Node.js 示例只验证单轮文本回复,禁用工具,并执行有超时保护的正常 WebSocket 关闭。它不验证音频播放、工具循环或历史记录保存;响应完成不等于历史已完整保存。
指令与单轮覆盖
-
session.instructions完整替换业务指令,""清空;Skill 作为另附指令独立存在。 - 平台会在每个会话的系统上下文后附加固定的会话时间参考:会话开始时间、时区(默认 Asia/Shanghai)和星期,用于理解“今天”“明天”。它不是实时时钟,不会被 instructions 替换。业务需要按指定日期判断时,请在用户消息或后端传入的上下文中写明日期;评测涉及日期的用例也应写明日期。
-
response.create.response.instructions/tools/tool_choice/output_modalities只覆盖本次响应,不改会话。 -
tools: []清空外部工具;Skill 读取工具由已挂载 Skill 提供。要一并移除,另传latentx.skills: []。 -
tool_choice支持auto、none、required和指定工具。没有可用工具时required报错。 -
none禁止本轮所有工具调用(包括 Skill 读取);预加载的 Skill 文本仍在指令中。 - 会话更新只允许响应空闲、无音频缓冲/待回传工具时执行。校验失败不修改生效配置;MCP 发现事件可能已发出,但不代表配置提交成功。
Function Calling:客户执行
{"type":"session.update","session":{"tools":[{"type":"function","name":"lookup_order","description":"查询订单","parameters":{"type":"object","properties":{"order_id":{"type":"string"}},"required":["order_id"]}}],"tool_choice":"auto"}}
收到 response.function_call_arguments.done(含
call_id/name/arguments),等待
response.done,在客户后端执行工具,再回传:
{"type":"conversation.item.create","item":{"type":"function_call_output","call_id":"返回的call_id","output":"{\"status\":\"已发货\"}"}}
{"type":"response.create"}
并行多个调用必须全部回传,再发起下一响应。工具等待期间请暂停上传下一轮音频;本版本拒绝交叉插入新用户回合,避免未完成工具结果污染上下文。重复/未知 call_id 会拒绝。模型的函数参数需由客户校验及授权后执行。
指定函数:"tool_choice":{"type":"function","name":"lookup_order"}。每次新响应会重新应用会话
tool_choice;如只需强制一次,放在 response override 中。
Remote MCP:平台执行
直接传标准 tools[type=mcp],无需 Admin 注册:
{"type":"session.update","session":{"tools":[{"type":"mcp","server_label":"orders","server_url":"https://your-public-host/mcp","authorization":"YOUR_MCP_TOKEN","allowed_tools":["lookup_order"],"require_approval":"always"}]}}
支持:server_label、server_url、server_description、authorization(Bearer
token)、headers、allowed_tools(字符串数组或
{tool_names:[...]})、require_approval(always/never 或
always/never 的 tool_names 过滤器)。默认需审批。session 事件不回显
authorization/headers。
要求公网 HTTPS、443 端口;拒绝凭据 URL、query、重定向、私网/元数据地址及 DNS 重绑定。只连接 HTTP MCP,客户端协商双方支持的版本;不提供 stdio、旧 SSE URL、OpenAI connectors/tunnels 或平台代办 OAuth。read_only 过滤器尚不支持,必须显式按工具名授权。
发现过程:mcp_list_tools.in_progress →
completed/failed,mcp_list_tools conversation item 含工具
schema。白名单缺失、重名工具、连接失败会使本次更新失败。同会话已成功导入的
server_label 可以只传 label 复用,跨会话必须重新给
URL/鉴权。更新凭据需同时传 URL。
调用过程:
-
免审批调用产生
mcp_call,参数事件response.mcp_call_arguments.delta/done。 -
要审批时产生
mcp_approval_request;等待response.done后发送:
{"type":"conversation.item.create","item":{"type":"mcp_approval_response","approval_request_id":"审批item的id","approve":true}}
-
平台执行后产生
response.mcp_call.in_progress/completed/failed,终态mcp_callitem 含 output/error。拒绝审批不会调用远端工具,结果为tool_call_rejected。 -
response.done 可以早于 MCP 结果。等待模型响应结束且全部工具完成,再主动发送
response.create让模型总结;不会自动生成下一回答。MCP 后续事件不额外重复扣一次模型费用。
指定 MCP
工具:"tool_choice":{"type":"mcp","server_label":"orders","name":"lookup_order"}。
流程 Skill 与知识:可选扩展
简单调用只需 model、instructions 和
tools。复杂业务可发布自定义模型,或在当前会话使用
session.latentx 的可选资源配置。它是 LatenTX 扩展。
{"type":"session.update","session":{"latentx":{"skills":[{"id":"support-sop","version":"v1","preload":true}],"knowledge_refs":[{"id":"support-faq","version":"v1"}],"mcp_refs":[]}}}Skill 管理流程与操作规则:preload=true 预加载正文,false 提供描述及 load_skill/read_skill_resource 工具。内联 Skill 可传 markdown、resources、required_tools;未传 markdown 时引用已保存版本。
知识管理事实与 QA,通过
/voice/v1/knowledge 创建版本后引用。挂载知识会自动提供
search_knowledge,仅搜索当前会话绑定的知识,由平台执行;无需客户注册同名 Function 或
MCP,也无需回传搜索结果。正文不强制 QA
格式,建议按主题、问题和答案组织。
省略 skills / knowledge_refs / mcp_refs 保留已有配置,[] 清空对应资源。资源必须属于当前租户;修改保存资源不会自动热更新当前会话。tools:[] 仅清空外部工具;tool_choice:none 禁止本轮工具,包括知识搜索和按需 Skill 读取。
用量与计费
Realtime 有两种计量模式,在连接时选择,不能通过 session.update
切换。文本和语音输入、输出分项计量。基础售价见
GET /voice/v1/catalog,实际费用以账户账单为准。
| 模式 | 客户端如何读取 |
|---|---|
| response(默认) |
现有客户端无需改动。从
response.done.response.usage 读取本响应的用量,按
response.id 去重。
|
| transcription(显式开启) |
从
conversation.item.input_audio_transcription.completed
的顶层 usage.seconds 读取本条转写秒数;按会话内
item_id 去重。响应的 usage
仍提供文本输入、文本输出和音频输出,语音识别不重复计入。
|
服务端 WebSocket 在握手发送
X-LatenTX-Usage-Mode: transcription;浏览器可使用
wss://api.latenth.com/v1/realtime?model=MODEL&usage_mode=transcription。选择一种方式即可,不要提交重复或冲突的值。收到
session.created 后检查
session.latentx.usage_mode:需要独立转写用量时,仅在值为
transcription 后开始发送音频。只消费 response
用量的客户端请保持默认模式。
示例一:只转写。 以下转写为 1.25 秒,即 125 个音频输入计量单位;即使没有创建 response 也应记录。每条转写按秒数 × 100 向上取整,不按连接时长估算。
{"type":"conversation.item.input_audio_transcription.completed","event_id":"event_demo","item_id":"item_demo","content_index":0,"transcript":"你好","usage":{"type":"duration","seconds":1.25}}
示例二:转写后语音回复。
若同一输入随后触发回复,上例的 125 单位只记一次。再从
response.done.response.usage
读取该回复的文本及音频输出用量;其中
input_token_details.audio_tokens 为
0。历史事件用于核对,不要把同一条实时和历史事件相加。
仅收到音频、静音或清空尚未提交的缓冲,不等于已完成转写。不要用本地录音时长、文本长度或断开时间补算。音频输出按合成字符数 × 100 计量;以上是 LatenTX 计量单位,不等同于 OpenAI 原生音频 tokenizer。
范围与限制
-
仅 WebSocket:不支持 OpenAI 原生 WebRTC
/v1/realtime/calls、client_secrets、SIP 控制、图像输入、音频 codec 切换、session 模型切换、输出 JSON schema。 - response override 仅支持上述四个字段;未实现字段明确报错。不承诺所有 OpenAI SDK 默认配置直接可用。
- 每会话最长 20 分钟;响应最长 120 秒。单次消息≤1MiB;指令/工具结果各≤64KiB;历史≤512KiB,最多512个 item。
- 最多32条工具定义、4个 MCP 服务、64个工具 schema,schema 合计≤128KiB;会话最多记忆16个 MCP label。发现总超时15秒,调用超时20秒;审批等待随会话到期或断线清理。
- 最多16个 Skill,预加载总指令≤128KiB。超额报错,需要主动精简。
- 保存资源更改不热更新已解析会话,重新 session.update 或新建会话读取。
参考:OpenAI Realtime MCP、Client events。
公共音色与自定义模型
从 GET /voice/v1/catalog 读取所选型号的 voices 与
default_voice,再用
session.audio.output.voice
选择音色。首次音频输出后不可变更。
自定义语音模型在 Console 组装、校验并发布后获得租户独有的
custom-...-vN 型号,可直接用于相同
/v1/realtime?model=...。发布版本固定 Prompt、Skill/MCP
配置和基础型号,草稿编辑不影响旧版。具体管理 API、计费与生命周期见
自定义模型文档。调用时无需额外创建或引用 Agent。
会话记录与查询
新会话默认记录事件、文本和最终转写。使用同一 API Key 查询
GET /voice/v1/conversations?origin=realtime 和
GET /voice/v1/conversations/{session_id}。
统一事件入口为
GET /voice/v1/conversations/{session_id}/events,适用于
Realtime、电话和网页。完整 Realtime 历史条目
data 使用实时披露映射,保留相同
event_id、类型、内容及来源内顺序。音频 Base64
分片不重复保存;已开启录音的会话通过
/recordings 获取录音分段。
按不透明 next_cursor 翻页,空 items
但有游标时继续。检查
capture_state:complete、collecting、partial、legacy、unavailable、expired
或
unsupported_mapping。旧记录不能补造;容量保护或异常退出可能留下部分记录。活跃会话结束后刷新查询;尝试发送不等于客户端收到或已播放。
请在 WebSocket 关闭后刷新历史查询;对外转发结果在连接结束时确认,未能确认时标记为部分采集。发送成功不等于客户端已收到或已播放。
取消、截断、工具失败不会抹去已保存内容。记录只对所属账号开放。内部成本、凭据、供应商和执行配置不披露。录音独立开通;没有录音不能重建音频。